EXPLAIN ANALYZE로 실제 Full Scan 발생 위치 확인keywordContains()가%keyword%인지 확인region -> parent -> grandParentJOIN 제거 가능성 확인- COUNT 전용 쿼리에서
roomType,region등 불필요한 JOIN 제거 likedOnly,notBlockedBetween을EXISTS / NOT EXISTS기반으로 검토- 검색 조건에 맞춰
roommate_board복합 인덱스 설계 - 최종적으로 total count가 정말 필요한지 확인 → 가능하면
Page→Slice
불필요한 count 연산 제거
게시물 목록 조회와 특히 count 쿼리에서 병목 발생한다.
노크인 게시물 조회 API 병목 지점노크인 게시물 조회 API 병목 지점. GitHub Gist: instantly share code, notes, and snippets.
 gist.github.com
COUNT 함수 자체가 병목이었던 것이 아니라, 다수의 JOIN과 동적 필터, EXISTS/NOT EXISTS 서브쿼리가 적용된 전체 결과 집합을 정확히 계산해야 했기 때문에 COUNT 쿼리의 비용이 데이터 증가에 따라 커졌다.
Long total = jpaQueryFactory
                .select(roommateBoard.count())
                .from(roommateBoard)
                .join(roommateBoard.roomType, roomType)
                .join(roommateBoard.region, boardRegion)
                .leftJoin(boardRegion.parent, parentRegion)
                .leftJoin(parentRegion.parent, grandParentRegion)
                .where(searchCondition) // 약 11가지의 조건 존재
                .fetchOne();
특히 서비스 요구사항이 무한 스크롤이어서 전체 개수가 불필요했으므로 Page를 Slice로 변경해 COUNT 쿼리 자체를 제거했다.
차단 테이블 풀스캔
게시물 자체 목록 조회 쿼리가 느린 것을 확인할 수 있었다.
2026-10-07-노크인-게시물-조회-API-SQL2026-10-07-노크인-게시물-조회-API-SQL. GitHub Gist: instantly share code, notes, and snippets.gist.github.com
H2 콘솔에서는 웜웝 이후 30회 반복 실행하여 집계해보니 평균 응답속도는 약 420ms로 측정됐다.
실행계획 측정
특정 쿼리의 지연을 DB 수준에서 파악했으니 H2 실행계획을 보며 병목 지점을 파악했다.
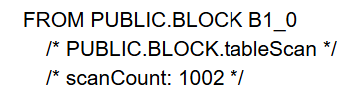
사용자 차단 여부를 확인하는 조건을 추가하자 응답속도가 평균 5ms → 400ms로 급증했다.
차단 테이블(BLOCK)에서 풀스캔을 도는 것을 확인할 수 있었다.
복합 인덱스 추가
우선 Block 테이블에 인덱스가 있는지 확인했다.
SELECT *
FROM INFORMATION_SCHEMA.INDEXES
WHERE TABLE_NAME = 'BLOCK';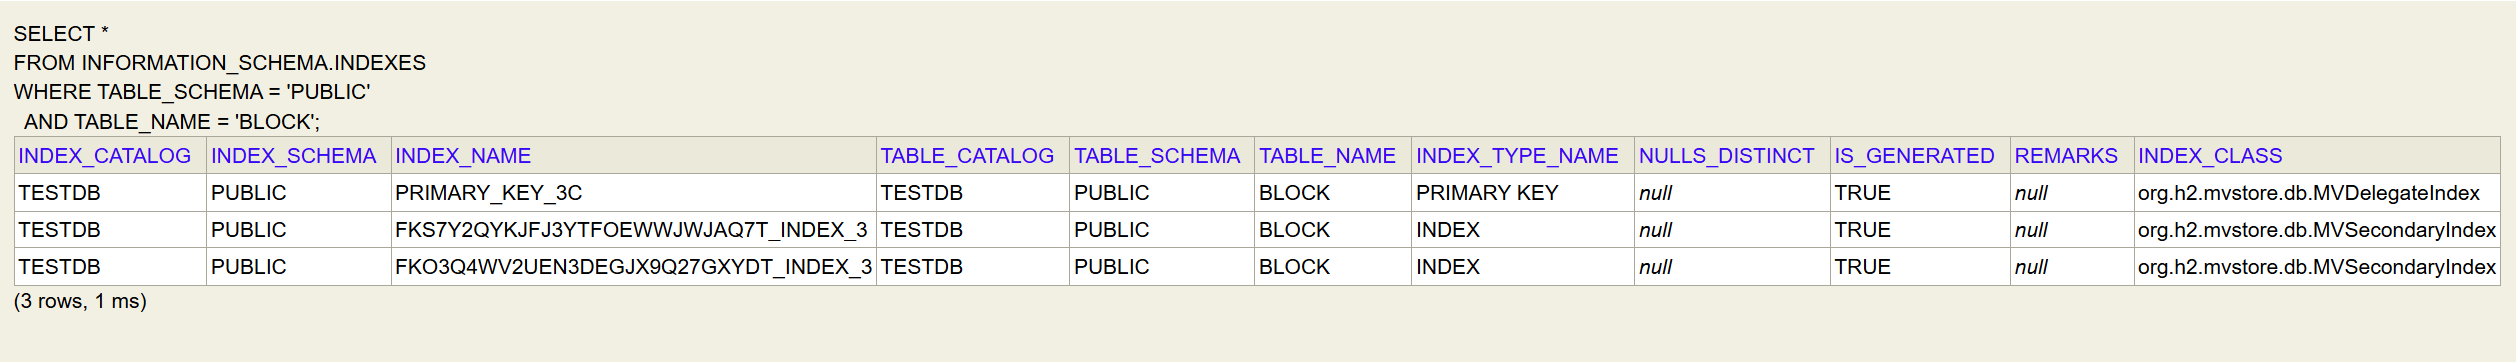
없었고, 복합 인덱스를 추가했다.
CREATE INDEX idx_block_blocker_blocked_deleted
ON block (
    blocker_id,
    blocked_id,
    is_deleted
);
OR 연산자 이슈
복합 인덱스를 추가했음에도 불구하고 여전히 성능에는 큰 변화가 없었고 다시 실행 계획을 확인했다.
새로 추가한 복합 인덱스가 타고 있음에도 불구하고 여전히 차단 테이블에 있는 수 만큼의 데이터를 조회하고 있었다.

기존에는 차단 여부를 OR로 나누어 확인하고 있었다.
not exists (
select 1
    from block b1_0
    where b1_0.is_deleted = false
      and (
          (
              b1_0.blocker_id = 5
              and b1_0.blocked_id = rb1_0.member_id
          )
          or
          (
              b1_0.blocker_id = rb1_0.member_id
              and b1_0.blocked_id = 5
          )
      )
)
OR 연산자 특성상 조건이 추가될 수록 B-Tree 구조의 인덱스에서 옵티마이저가 후보로 줄일 수 있는 데이터의 크기가 점점 커질 것이다. 드모르간 법칙에 기반하여 순수한 AND 연산자 위주 쿼리문으로 변경했다.
-- 상대방이 나(5)를 차단했는지
and not exists (
    select 1
    from block b1_0
    where b1_0.is_deleted = false
      and b1_0.blocked_id = 5
      and b1_0.blocker_id = rb1_0.member_id
)

-- 내(5)가 상대방을 차단했는지
and not exists (
    select 1
    from block b4_0
    where b4_0.is_deleted = false
      and b4_0.blocker_id = 5
      and b4_0.blocked_id = rb1_0.member_id
)
이후 인덱스 스캔이 정상적으로 동작됨을 확인할 수 있었고 성능 측정까지 진행했다.
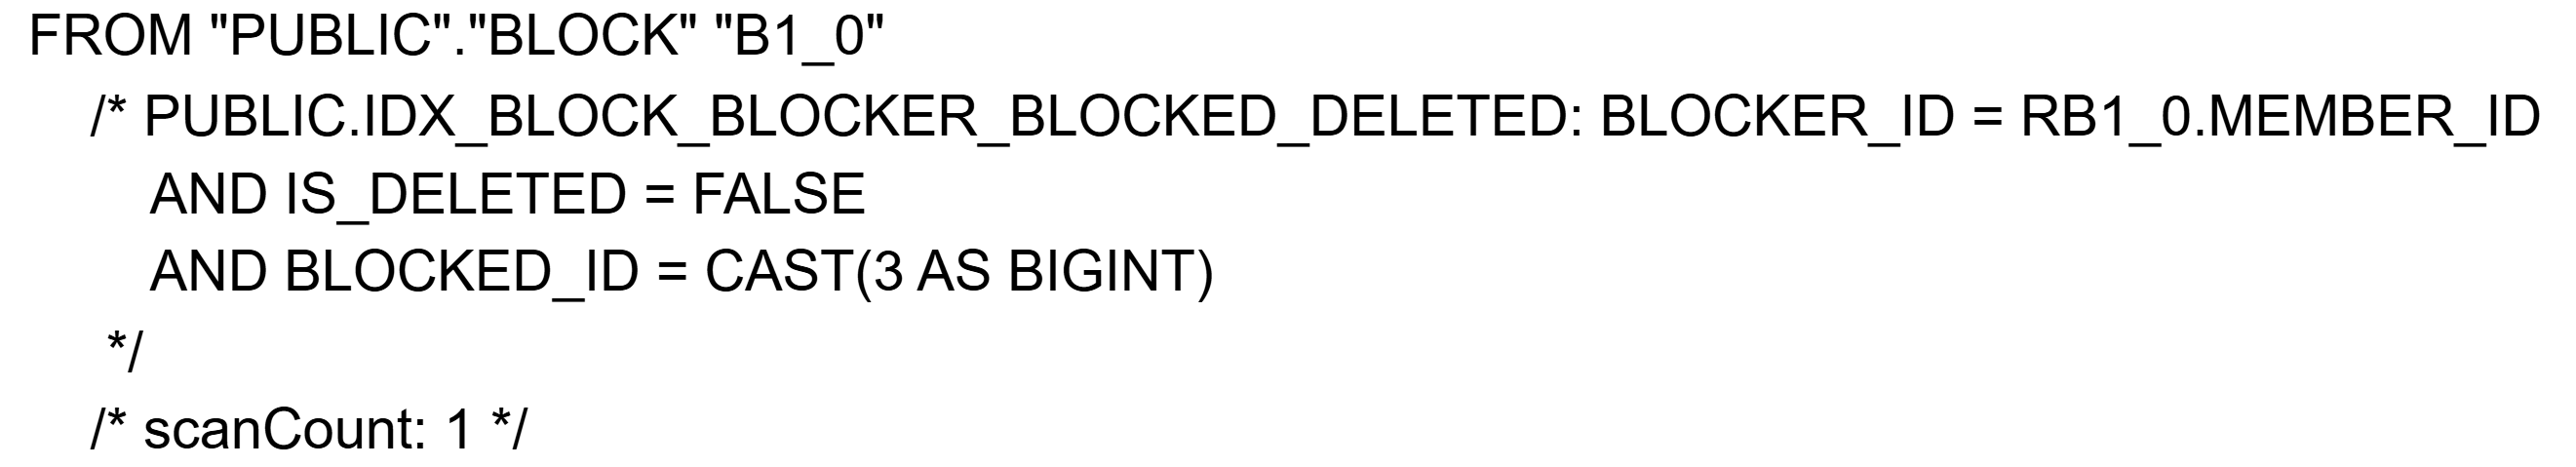
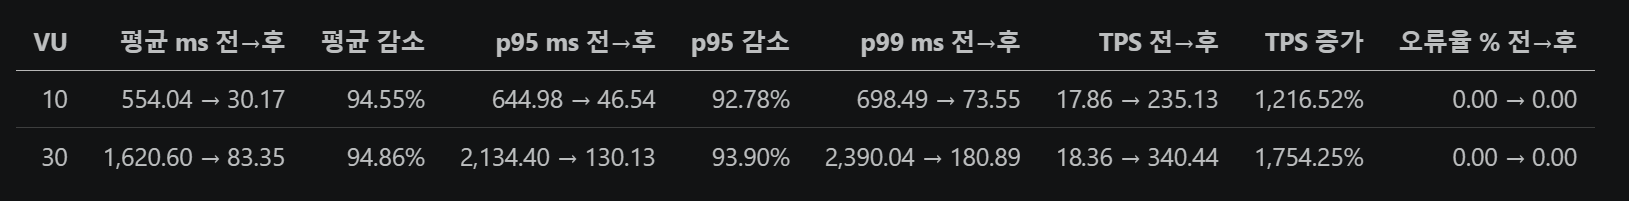
수정된 sql의 형태는 다음과 같다.
2026-10-07-노크인-게시물-조회-API-SQL-V22026-10-07-노크인-게시물-조회-API-SQL-V2. GitHub Gist: instantly share code, notes, and snippets.gist.github.com
인덱스는 스크립트로 관리
추가된 인덱스는 Spring에서 기본적으로 제공하는 init 기능을 활용했다.
# Spring Boot의 SQL 초기화 기능을 항상 실행
spring.sql.init.mode=always
# SQL 초기화 과정에서 실행할 스키마 SQL 파일의 위치를 지정
spring.sql.init.schema-locations=classpath:db/index.sql
# SQL 초기화를 JPA/Hibernate의 초기화 이후로
spring.jpa.defer-datasource-initialization=true게시글 테이블 풀스캔
순수한 조회로 바꾸기
게시물 조회시 검색기록을 저장한다는 요구사항이 있었기에 조회 로직 안에 쓰기 작업이 존재한다.
@Override
@Transactional
public Slice<BoardListDto.Response> getBoardList(...) {
	// 검증 작업
    saveSearchKeyword(requesterId, request.getKeyword()); // <- 쓰기 작업
    // 조회 작업
}
그렇기에 @Transactional에 readOnly 속성을 활용하지 못한다는 단점이 있다.
Spring, JPA 환경에서 읽기 전용 트랜잭션의 특징은 다음과 같다.
추가로 현재 Replication 도입을 고려 중이기에 이 작업은 필연적이다.
- 변경 감지 비활성화(스냅샷 비활성화를 통해 스냅샷을 생성하기 위한 메모리를 사용하지 않아 성능 상 이점을 가져갈 수 있음)
- 모든 락(Lock)이 아닌 읽기 락(Lock)만 획득 -> 락 획득 최소화
- 트랜잭션 로그 생성 생략
- 플러시(
flush())모드가 수동으로 설정 돼 자동 플러시 방지 -> 읽기 전용이므로 flush가 불필요하다 판단
성능개선을 위해 순수한 읽기 로직으로 리팩토링을 진행했다.
리팩토링 방식 후보는 다음과 같았다.
- 별도 POST 기록 방식
- 비동기 이벤트 방식
- 트랜잭션만 분리하는 방식
이 중에서도 현재 클라이언트의 변경이 어렵다는 점과 멀티모듈로 전환을 고려하여 비동기 이벤트 방식을 택했다.
그 중에서도 구체적인 서버의 성능이나 팀 내 합의된 부분이 없었기에 비동기 작업에 대한 전용 executor까지는 도입하지 않았다.
현재 시점으로는 FCM도 별도의 executor 없이 비동기로 수행되는 중이다.
비동기 이벤트 방식
우선 주 기능은 게시물 조회이고 이에 부가적인 서브 기능을 검색 기록 저장이라고 할 수 있다.
그 이유는 다음과 같다.
- 서비스적으로 게시글 조회 결과에 대한 성능 최적화가 가장 최우선
- 검색 기록이란 도메인이 현재 서비스의 비중이 높지 않음
- 검색기록 저장이 실패하더라도 시스템적으로 문제 없음 (데이터 정합성 이슈 없음)
그렇기에 별도의 스레드로 분리 및 비동기 처리하되 복구 전략까지도 현재 단계에서는 필요 없다고 판단하였다.
오해: 사실 인덱스는 추가할 필요가 없었다.
처음에 fk 인덱스를 타지 않는 것을 확인 후 복합 인덱스를 추가했다.
그리고 복합 인덱스 내부에서 Index Full Scan이 발생하는 것을 확인 후 쿼리 개선 작업을 수행했다.
이후 팀원과 실제 MySQL DB 환경에서 직접 다시 테스트 해본 결과 별도의 복합 인덱스 추가 없이 쿼리 개선만으로도 충분한 성능을 보장 받을 수 있음을 확인했다.
| 단계 | 인덱스 상태 | 쿼리 상태 | 실제 동작 방식 (Access Type) | 성능 결과 및 이유 |
|---|---|---|---|---|
| 1단계 (초기) | 기본 FK 단일 인덱스만 존재 | OR 통합 쿼리 | Full Scan | OR 때문에 기본 FK 인덱스의 시작점을 못 잡아 전체 스캔 (약 420ms) |
| 2단계 (인덱스 추가) | 복합 인덱스 추가 | OR 통합 쿼리 | Index Full Scan (scanCount: 1002) | 복합 인덱스를 선택하긴 했지만, 여전히 OR 때문에 시작점을 못 잡아 인덱스 전체를 처음부터 끝까지 다 읽음 (여전히 느림) |
| 3단계 (쿼리 개선) | 복합 인덱스 유지 | NOT EXISTS 분리 (AND) | Composite Index Seek (scanCount: 1) | OR가 사라져 복합 인덱스의 3개 컬럼 좌표로 정확히 1건만 점프 (초고속, 약 5ms) |
| 4단계 (교차 검증) | 복합 인덱스 제거 (기본 FK만 존재) | NOT EXISTS 분리 (AND) | FK Index Range Scan | 복합 인덱스가 없어도 blocker_id 단일 FK 인덱스를 타고 내가 차단한 목록으로 즉시 점프 (초고속) |
복합 인덱스를 추가로 인한 삽입 지연을 개선하고자 DB Replication 도입을 고려 중이었기에 확실한 검증 과정은 필요했다.
Perf: 룸메이트 차단 관계 조회 쿼리 튜닝 최종 분석 반영 및 인덱스 정리 by Developer-Choi-Jae-Young · Pull Request #361 · Team-Unearned-Income/11th-1team-BEPR 타입(하나 이상의 PR 타입을 선택해주세요) Feat : 새로운 백엔드 기능 추가 Bug : 서버/로직 버그 발견 및 수정 Refactor : 백엔드 코드 구조 개선 Chore : 의존성/설정/인프라 유지보수 API : API 엔드포인트 및 스펙 변경 DB : DB 스키마/쿼리/마이그레이션 변경 Performance : 성능 개선 ...github.com