단일 조회부터 안정화
부하 테스트시 DB 환경을 어떻게 구축할지 고민했다. 일단 1차적으로 내린 결론은 기존의 H2 방식으로 진행하되 운영 환경인 PostgreSQL과는 다른 환경임을 인지하고 개발을 진행하기로 했다.
seed.load-test.records-per-entity=10000위와 같이 설정하여 기존에 있던 SeedDataConfig 클래스에 반복문으로 동일한 임시 데이터를 삽입하는 방식으로 진행했다.
그러나 게시물이 10,000건일때 TimeOut이 발생했다.
TimeOut 설정이 5초이기에 단일 조회 자체가 5초 소모된다는 것이기에 우선 단일 조회 자체 성능부터 안정화 할 필요가 있다.
1차 테스트
첫 요청은 JVM/DB/cache 등의 영향 때문에 유난히 느릴 수 있다.
첫 요청을 제외한 10회 테스트 진행
-
10건
- 350 ms
- 537 ms
- 380 ms
- 317 ms
- 334 ms
- 323 ms
- 340 ms
- 399 ms
- 490 ms
- 363 ms
-
100건
- 420 ms
- 241 ms
- 337 ms
- 355 ms
- 646 ms
- 376 ms
- 369 ms
- 328 ms
- 423 ms
- 411 ms
-
500건
- 903 ms
- 1005 ms
- 854 ms
- 761 ms
- 984 ms
- 811 ms
- 682 ms
- 666 ms
- 911 ms
- 1063 ms
-
1,000건
- 1950 ms
- 1562 ms
- 2050 ms
- 1872 ms
- 2164 ms
- 1639 ms
- 782 ms
- 875 ms
- 1873 ms
- 1643 ms
시드데이터 10,000건 이상부터 타임아웃이 발생했기에 설정을 아래와 같이 다시 설정
HTTPRequestControl.setConnectionTimeout(30000)
HTTPRequestControl.setSocketTimeout(30000)
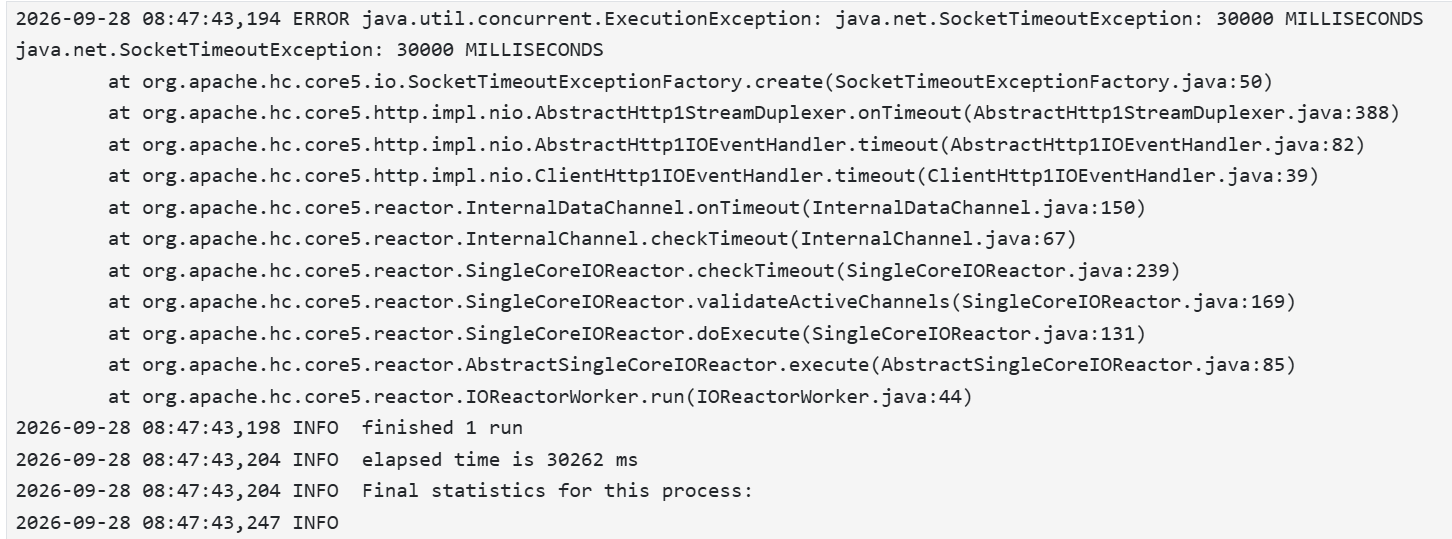
그럼에도 불구하고 타임아웃이 발생했고 시드데이터 10,000건 이상 환경은 더 이상 측정하는 의미가 없다고 판단함.
- 10,000건
- 30322 ms
- 30262 ms
우선 2,000건 3,000건 먼저 측정했다.
데이터가 2배 증가했음에도 불구하고 응답시간이 4배 가까이 증가
- 2,000건
- 7328 ms
- 7381 ms
- 6443 ms
- 7242 ms
- 5917 ms
- 6450 ms
- 5860 ms
- 5738 ms
- 6696 ms
- 5866 ms
1,000건 ~ 2,000건 사이를 자세히 측정함
- 1,250
- 1096 ms
- 2738 ms
- 3068 ms
- 2352 ms
- 2816 ms
- 3068 ms
- 2445 ms
- 3046 ms
- 2600 ms
- 2725 ms
결론
→ 적절한 시드 데이터의 사이즈를 정하는게 우선이라고 생각
→ 아래 지표를 측정하기 위해 서버를 on/off를 반복하면서 nGrinder UI를 통해 반복 실행 및 복붙을 반복함. 이를 좀 자동화 할 수 있는 방법을 고민
우선 아래와 같이 스크립트를 구성
- 특정 시드 데이터 크기로 서버 실행
- nGrinder에 등록된 모든 스크립트들을 각각 N번씩 실행 (이때 각 응답-요청이 겹치치 않는게 좋다면 그렇게 설정)
- 실행결과 수집 후 기록
결과는 TPS 10 이하에서도 에러가 발생하는 처참한 성능을 확인했다.
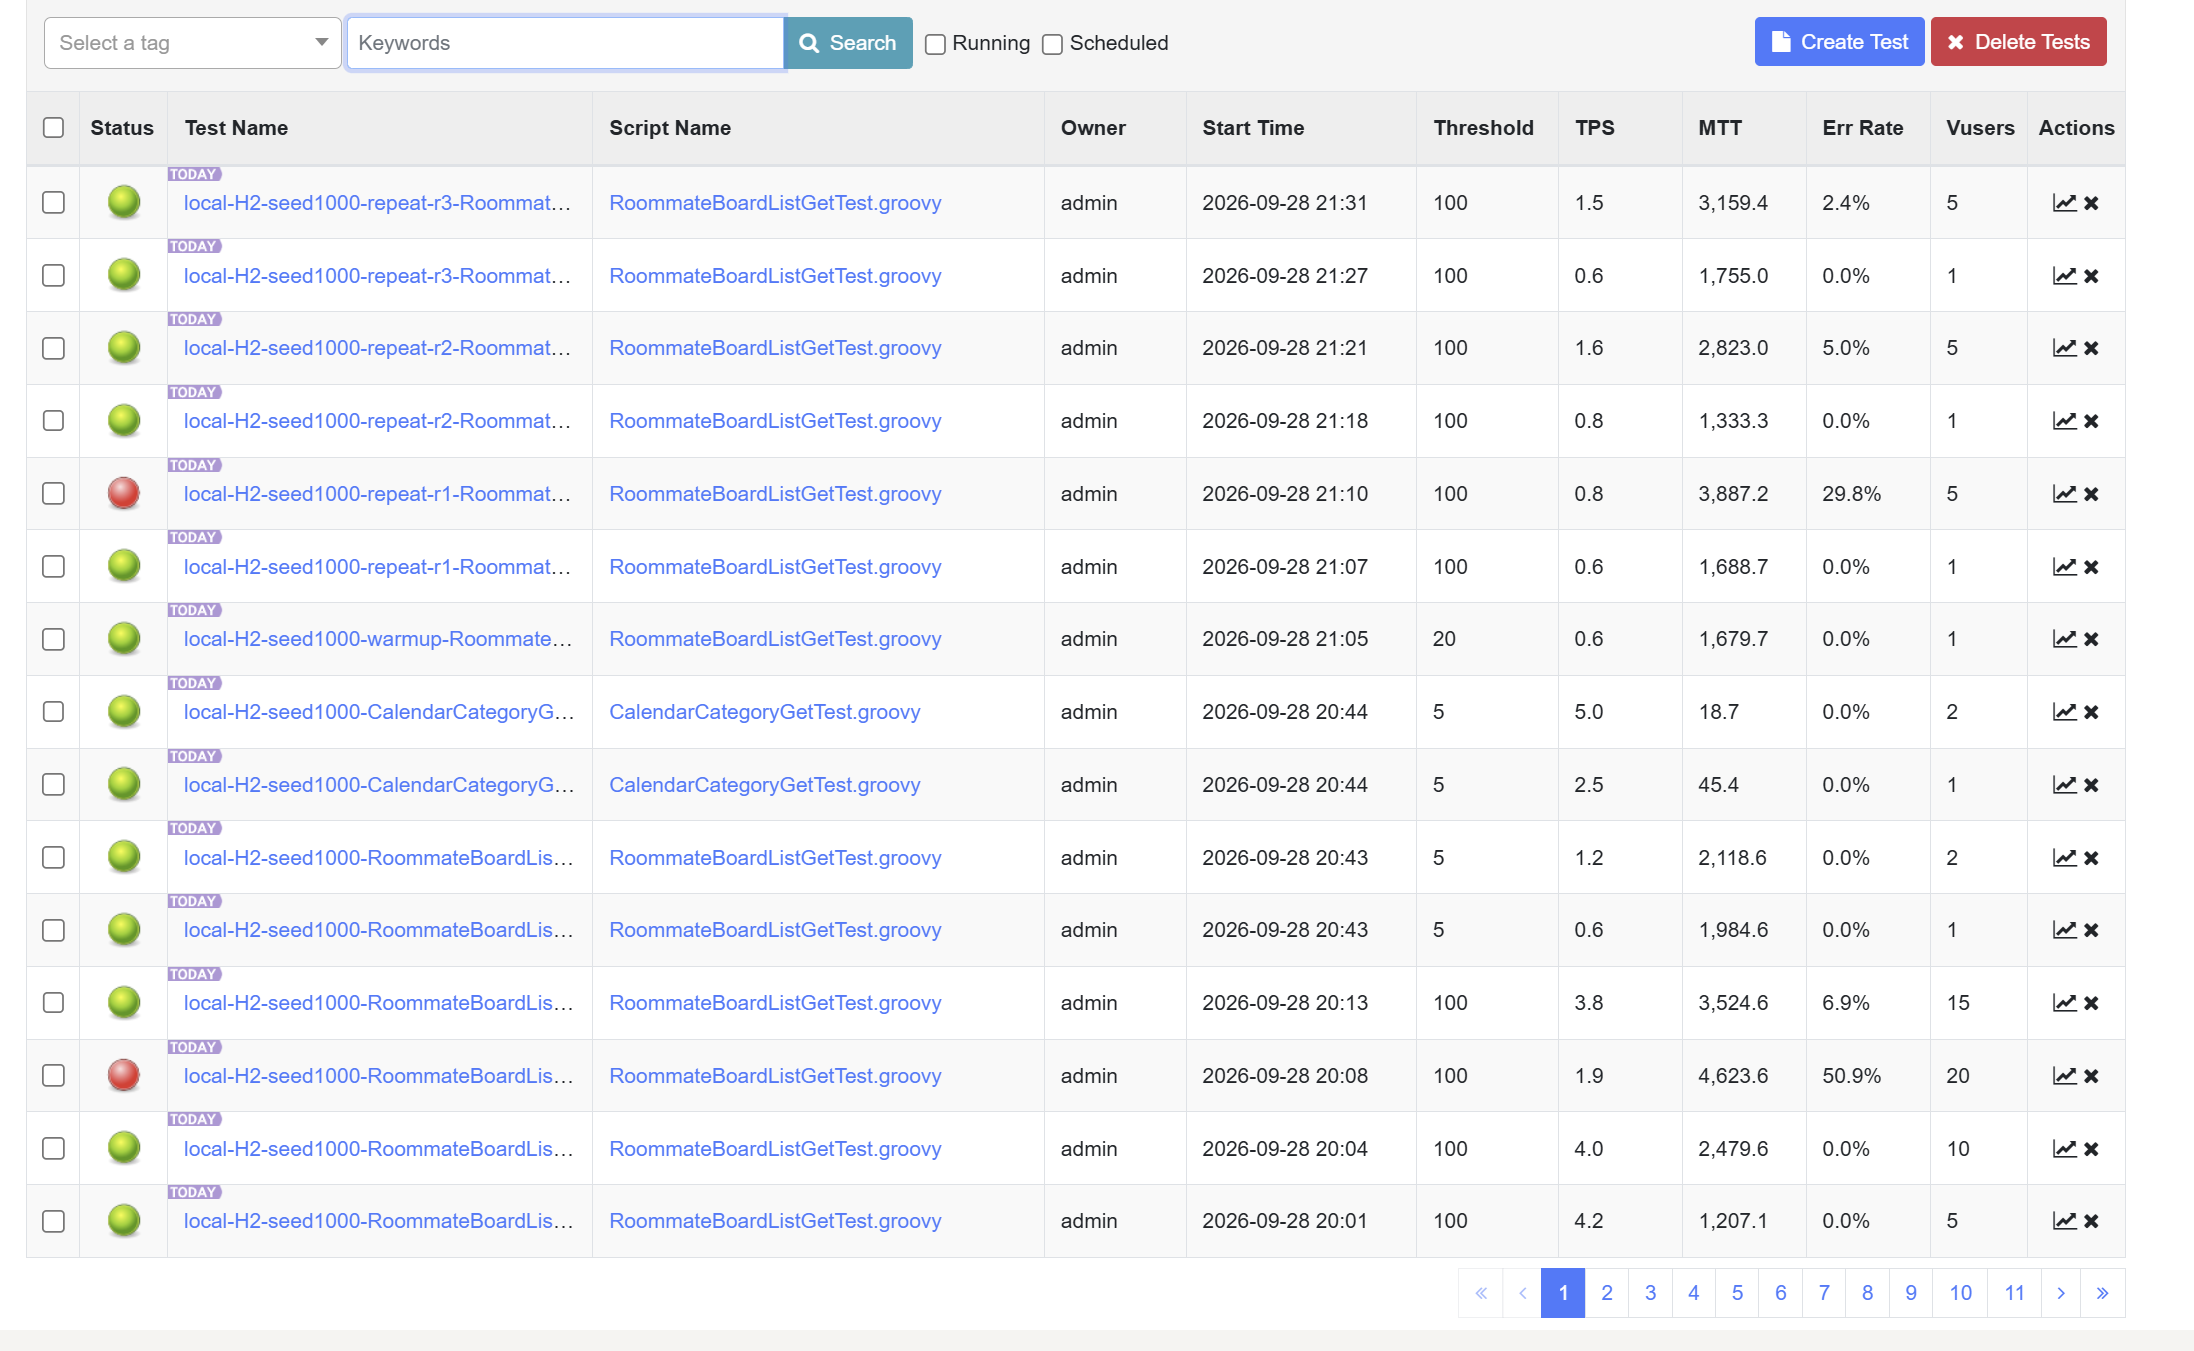
일단 부하 테스트 환경에는 대표적으로 다음과 같은 문제가 있다.
- H2 사용으로 CPU 및 메모리를 크게 점유
- 서버, nGrinder, 외부 다른 작업까지 동시에 수행
우선 재현 환경을 통일 시키고 좀 더 일관성 있는 지표가 필요할거 같다.
시드데이터 규모를 잡고 다양한 조건으로 진행
우선 시드 데이터 사이즈를 1,000으로 설정하고 작업을 진행했다.
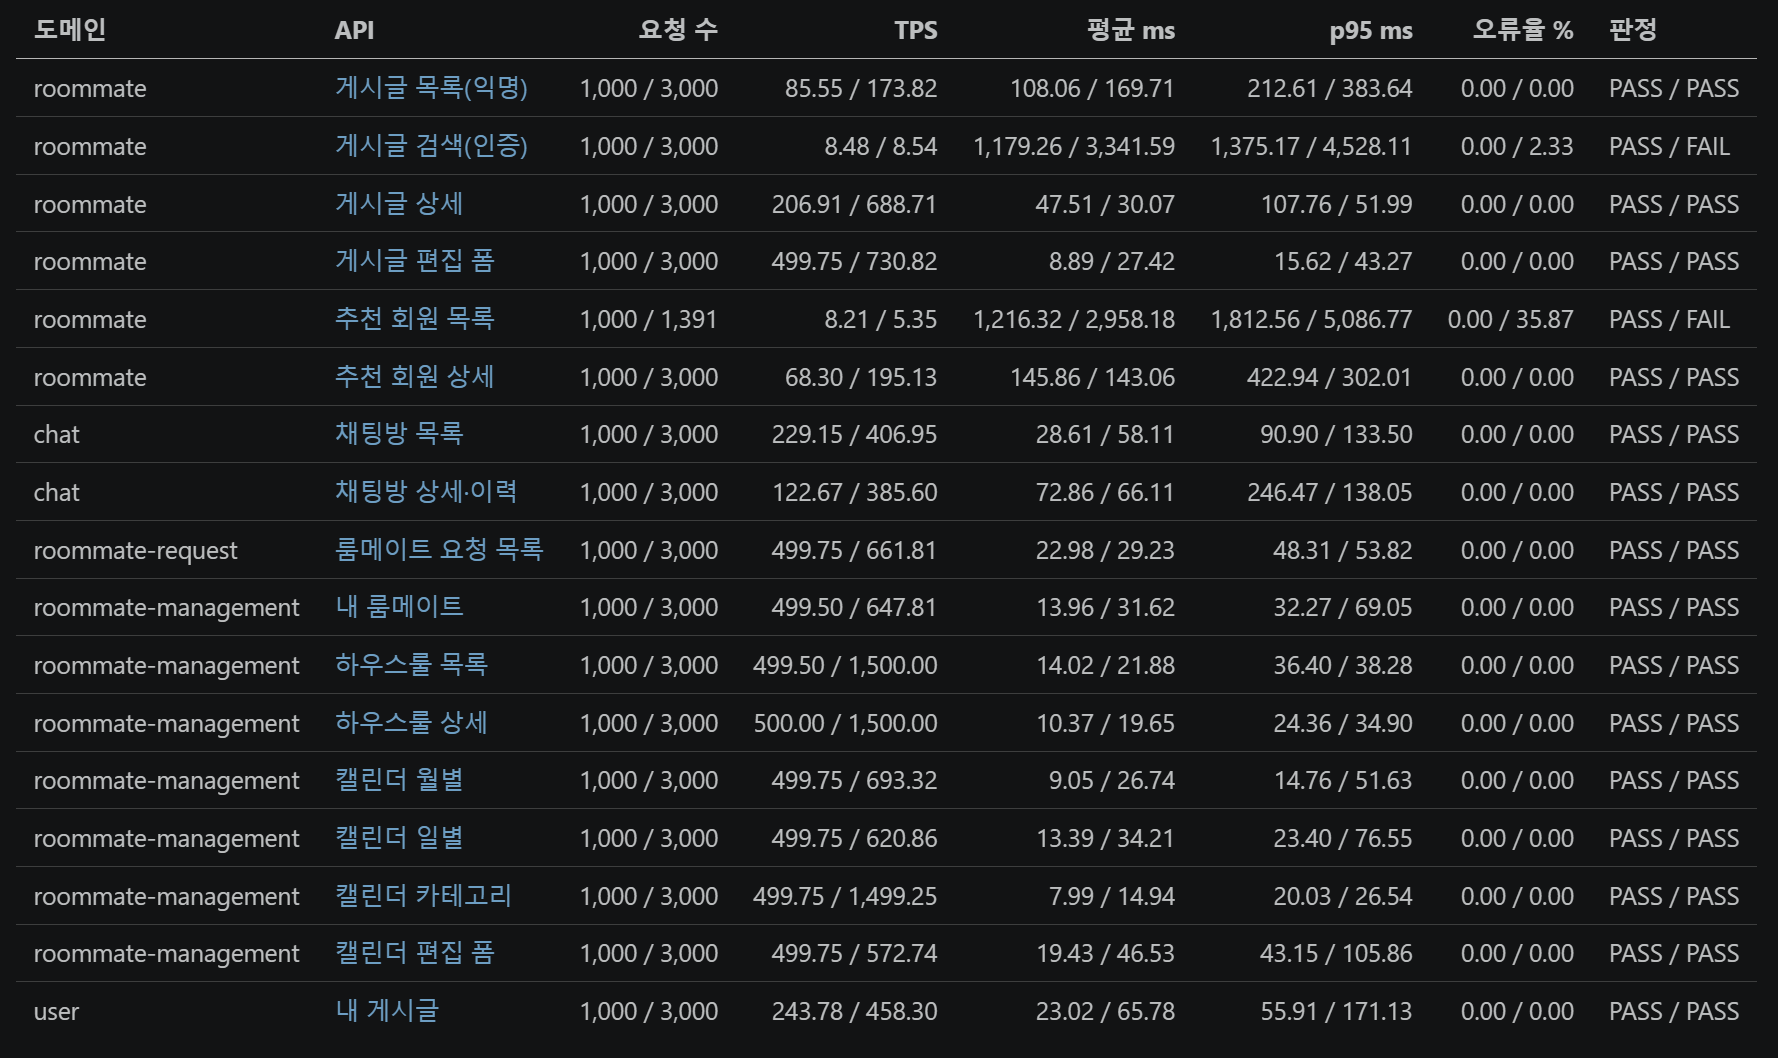
전체적인 API 조회
TPS 기준 느린 쿼리
- 게시물 목록:
GET /roommate/boards - 추천 회원 목록:
GET /roommate/matches - 추천 회원 상세:
GET /roommate/matches/{memberId}