데이터베이스 인덱스는 책의 목차와 같이, 테이블의 데이터 검색 속도를 높이기 위해 사용하는 자료구조이다.
- Full Table Scan을 방지
- 주로 B-Tree, Hash 구조로 설계
- Clustered Index와 Non-Clustered Index로 나뉨
- 장점: 검색 성능이 향상, 정렬/그루핑에 최적화
- 단점: 쓰기 성능 저하, 저장 공간 증가
Clustered Index vs Non-Clustered Index
| 구분 | 클러스터드 인덱스 (Clustered Index) | 넌클러스터드 인덱스 (Non-Clustered Index) |
|---|---|---|
| 물리적 정렬 | 데이터가 인덱스 키 순서대로 물리적으로 재배열됨 | 데이터의 물리적 정렬 없이 별도의 인덱스 페이지를 생성함 |
| 개수 제한 | 테이블당 1개만 생성 가능 | 테이블당 여러 개 생성 가능 (보통 240~250개 제한) |
| 리프 페이지 구성 | 리프 페이지가 실제 데이터(행) 그 자체 | 리프 페이지에 데이터의 **주소값(포인터/RID)**을 저장 |
| 검색 속도 | 리프 노드에 데이터가 바로 있어 조회 속도가 빠름 | 인덱스 검색 후 데이터 위치로 이동해야 해서 추가 연산(RID Lookup) 필요 |
| DML(입력/수정/삭제) 성능 | 데이터 삽입/수정 시 물리적 정렬을 유지해야 하므로 느림 | 별도 공간에 인덱스만 갱신하므로 클러스터드보다 상대적으로 빠름 |
| 자동 생성 여부 | 기본키(PK)를 설정하면 자동으로 생성됨 | CREATE INDEX 구문 등으로 사용자가 직접 생성함 |
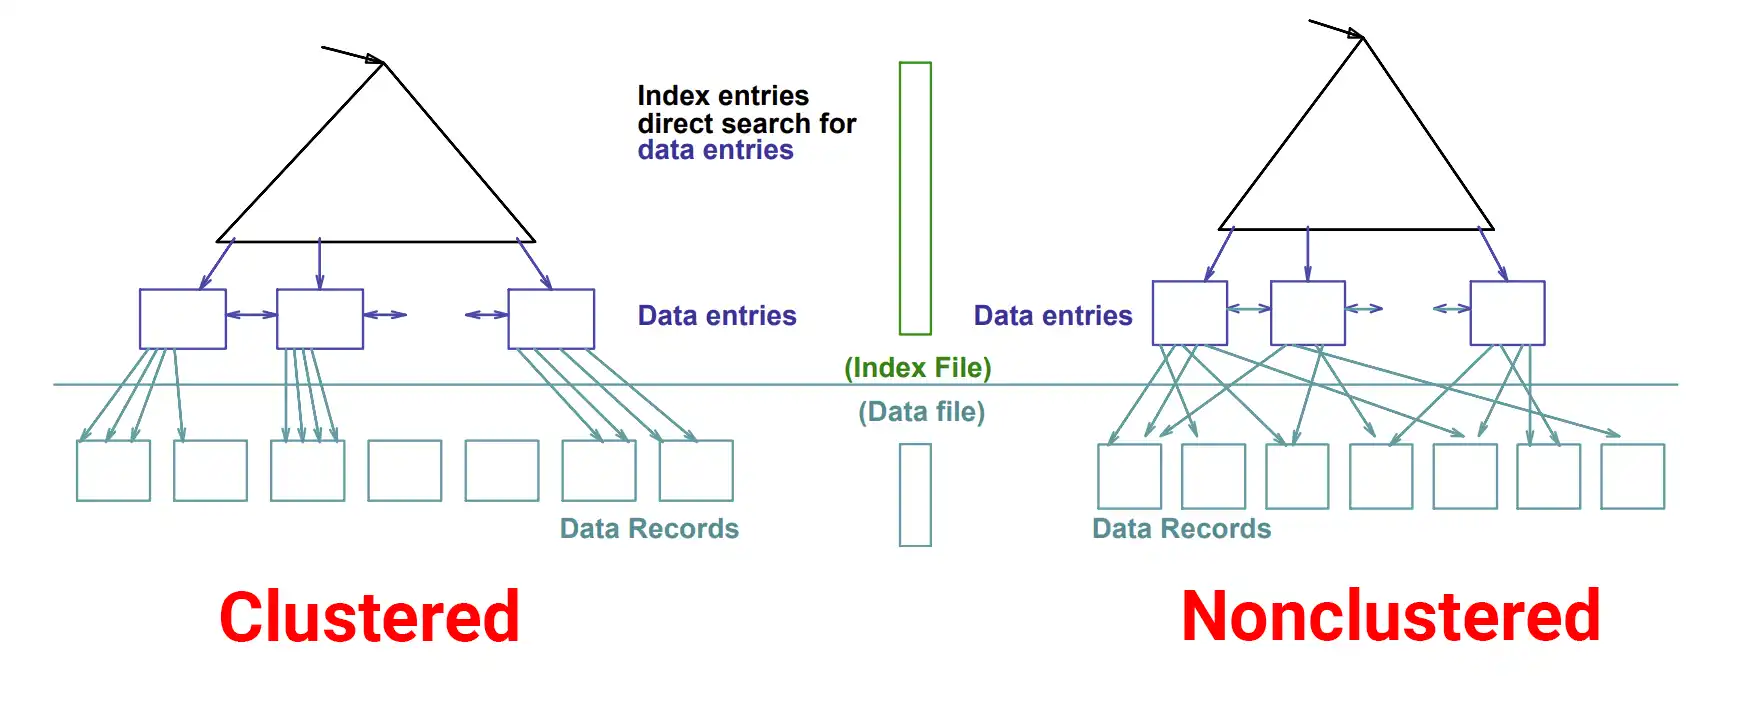 |
Clustered Index
Clustered Index란 인덱스의 정렬 순서와 실제 테이블 데이터의 저장 순서가 동일하도록 구성된 인덱스이다.
- 테이블 당 하나만 존재
- DBMS에서 PK에 적용된 Clustered Index를 생성
- 리프 노드에 레코드의 모든 컬럼이 저장
다음과 같은 환경에서 이점이 존재한다.
- 테이블 데이터가 자주 업데이트 되지 않는 경우
- 항상 정렬 된 방식으로 데이터를 반환해야하는 경우
- 읽기 작업이 월등히 많은 경우, 이때 매우 빠르다.
Non-Clustered Index
Non-Clustered Index란 인덱스와 실제 테이블 데이터가 별도로 저장되는 인덱스이다.
- 하나의 테이블에 여러개 존재 가능
- 인데스 키 값과 데이터 행을 가리키는 포인터가 존재 (사실상 두번의 인덱스 탐색)
다음과 같은 환경에서 이점이 존재한다.
where절이나join절과 같이 조건문을 활용하여 테이블을 필터링 하고자할 때- 데이터가 자주 업데이트 될 때
- 특정 컬럼이 쿼리에서 자주사용 될 때
Composite Index
복합 인덱스는 데이터베이스에서 두 개 이상의 컬럼을 조합하여 생성하는 인덱스이다.
CREATE INDEX idx_user_name_age ON users (name, age);사용 시점
- 조회할 것으로 예상되는 row 수(selectivity)
- 테이블 크기
- row 크기
- 데이터가 몇 페이지에 흩어져 있는지
- 캐시 상태에 대한 가정
seq_page_costrandom_page_cost- CPU 비용
- Index Only Scan 가능 여부
- Bitmap Index Scan 가능 여부
LIMIT,ORDER BY등
Index가 B-Tree로 설계된 이유
B-Tree Index는 self-balancing BST에 비해 Secondary Storage 접근을 적게 수행한다.
B-Tree 노드는 Block 단위의 저장 공간을 더 효율적으로 활용한다.
아래 정리글은 해당 유튜브 영상을 참고했습니다.
BJ.54-3 B tree가 왜 DB 인덱스(index)로 사용되는지를 설명합니다#btree #DB #index #쉬운코드 #백발백중B tree 외에도 AVL tree도 있고 red-black tree도 있는데, 왜 B tree 계열의 자료 구조가 DB index로 사용되는 걸까요?오늘은 그 얘기를 자세히 풀어보겠습니다그럼 오늘도 고고씽!00:00 오프닝00:...
 www.youtube.com
B-Tree에서 조회/삽입/삭제의 시간 복잡도는
BST는 상황에 따라 한쪽으로 기울어진 형태가 될 수 있다.
그렇기에 스스로 균형을 맞추는 self-balancing BST = AVL Tree, Red-Black Tree가 등장.
self-balancing BST 또한 인데, 그렇다면 굳이 왜 B-Tree를 사용하는걸까?
컴퓨터 시스템 구조는 대략 다음과 같음.
CPU → Main Memory (RAM) → Secondary Storage (SSD/HDD)
각각의 역할과 특징은 다음과 같음.
- CPU: 프로그램을 실제로 실행
- RAM: 실행 중인 프로그램의 코드들과 코드 실행에 필요한 혹은 그 결과로 나온 데이터들이 상주
- Secondary Storage: 프로그램 데이터가 영구적으로 저장되는 곳 (←> RAM은 임시 저장)
- RAM의 용량은 한계가 있기에 실행 중인 프로그램의 데이터 일부가 임시 저장되기도 함
- block 단위로 데이터를 읽고 쓴다
- block이란?
- file system이 데이터를 읽고 쓰는 단위
- block의 크기는 2의 승수로 표현되며 대표적인 block size는 4KB, 8KB, 16KB
- 해당 방식은 불필요한 데이터까지 가져올 수 있다는 단점이 있음
- block이란?
DB는 Secondary Storage에 저장된다. (근본적인 이유는 영구적인 저장을 위해)
그렇기에 아래와 같은 특수성을 고려해야 된다. (DB Index가 B-Tree 구조인 이유)
- DB에서 데이터를 조회할 때 Secondary Storage에 최대한 적게 접근하는 것이 성능적으로 중요
- Block 단위로 읽고 쓰기에 연관된 데이터를 모아서 저장하면 효율적일 수 있음
더 생각해보기
BST 노드들에도 Block 안에 연속된 데이터를 최대한 담는다면?
→ 결국 B-Tree 동작 방식과 동일하기에 차라리 B-Tree를 도입Hash Index는 시간 복잡도가 인데 왜 사용하지 않는가?
→=조회만 가능, 범위 기반 검색이나 정렬은 불가능
출처 및 참고자료
BJ.54-3 B tree가 왜 DB 인덱스(index)로 사용되는지를 설명합니다#btree #DB #index #쉬운코드 #백발백중B tree 외에도 AVL tree도 있고 red-black tree도 있는데, 왜 B tree 계열의 자료 구조가 DB index로 사용되는 걸까요?오늘은 그 얘기를 자세히 풀어보겠습니다그럼 오늘도 고고씽!00:00 오프닝00:...www.youtube.com
인덱스 (데이터베이스) - 위키백과, 우리 모두의 백과사전
 murphytklee.tistory.com