Stack
스택이란 한쪽 끝에서만 데이터를 넣고 뺄 수 있는 후입선출 형태를 지닌 선형 자료구조 입니다.
특징
- FIFO: 후입선출을 따릅니다
- 단일 접근 지점 : top 위치에서만 삽입/삭제 가능합니다.
- 중간 요소 접근 불가 : 임의 위치에 대한 조회, 수정, 삽입, 삭제가 허용되지 않습니다.
BFS에서 주로 사용됩니다.
종류
스택은 크게 두가지로 나뉩니다.
- Register Stack
- Memory Stack
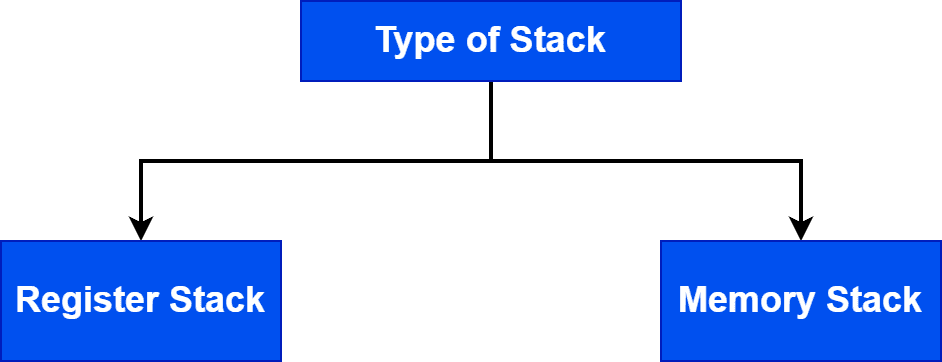
레지스터 스택은 일반적으로 CPU의 메모리 위치를 가리키며, 스택의 최상위 영역에 있는 요소들의 주소를 저장합니다.
메모리 스택은 메모리 레지스터에 비해 많은 양의 데이터를 저장하는 메모리 위치를 지칭합니다.
메모리 레지스터의 스택 깊이는 가변적입니다.
주요 연산
push(): 스택의 맨 끝(top)에 요소를 삽입합니다.pop(): 스택이 비어 있지 않으면 스택의 맨 위에 있는 요소를 제거하고 반환합니다.peek(): 스택이 비어 있지 않으면 스택의 맨 위에 있는 요소를 제거하지 않고 반환합니다.size(): 스택에 있는 요소의 개수를 반환합니다.isEmpty(): 스택이 비어 있으면 true를 반환하고, 그렇지 않으면 false를 반환합니다.isFull(): 스택이 가득 찼으면 true를 반환하고, 그렇지 않으면 false를 반환합니다. 고정 용량 스택(예: 배열 기반 스택)에만 해당됩니다.capacity(): 용량을 반환합니다. (기본은 10이며 동적으로 2배씩 증가한다)
pop()과peak()둘 다 top에 있는 데이터를 반환하는 연산이다.
pop()은 top에 있는 데이터를 제거하는 반면peak()는 요소를 제거하지 않고 값만 반환한다.
구현
스택은 주로 배열과 연결 리스트를 기반으로 구현됩니다.
배열 기반 스택
구조
- 고정 크기 혹은 동적 배열을 이용해 연속된 메모리 공간에 데이터 저장합니다.
- top 인덱스 값만 증가 또는 감소시키며 push/pop 수행합니다.
특징
- 인덱스 접근이 가능하지만 스택에서는 사용하지 않습니다.
- 연속된 메모리 할당 필요합니다.
- 크기를 미리 결정해야 하며, 꽉 차면 재할당 필요합니다. (ArrayList와 같이)
장점
- 접근이 빠르고 캐시 친화적입니다. (메모리 연속성)
- 구현이 매우 간단합니다.
- push/pop이 상수 시간 O(1)로 안정적입니다.
- 메모리 오버헤드가 적습니다. (포인터가 없음)
단점
- 크기 제한이 있습니다.
- 정적 배열: 크기를 초기에 고정합니다.
- 동적 배열: 확장 시 전체 복사가 필요합니다. → O(n)
- 메모리가 연속적이어야 하므로 크기가 큰 스택은 메모리 단편화 문제가 발생할 수 있습니다.
연결 리스트 기반 스택
구조
- 단일 연결 리스트의 head를 스택의 top으로 사용합니다.
- push = head에 노드 추가합니다.
- pop = head에 노드 제거합니다.
특징
- 동적으로 노드를 하나씩 할당하기 때문에 크기 제한이 없습니다.
- 메모리 연속성이 필요 없습니다.
장점
- 스택의 크기에 제한이 없습니다.
- push/pop 모두 head에서 발생합니다.
- 배열처럼 확장/재할당 필요 없습니다.
단점
- 각 노드가 참조를 포함하므로 메모리 오버헤드가 존재합니다.
- 동적 메모리 할당 비용이 존재합니다.
- 캐시 비친화적입니다.
- 복잡성 높습니다.